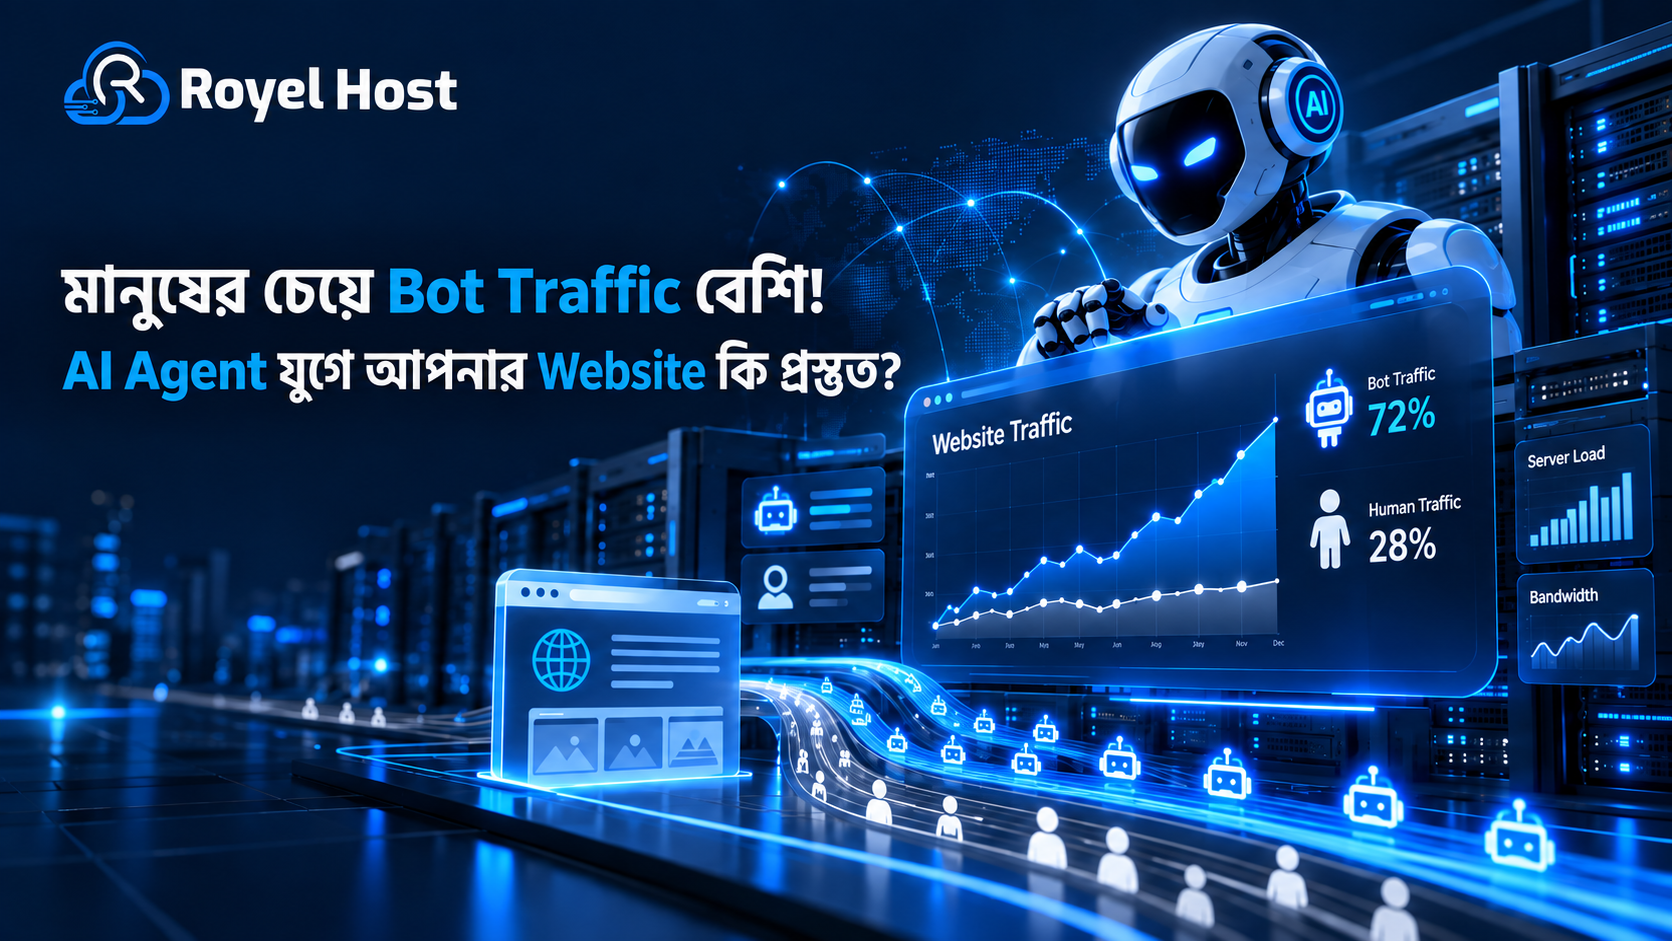
মানুষের চেয়ে Bot Traffic বেশি! Cloudflare বলছে Automated Traffic Human Traffic-কে ছাড়িয়েছে—AI Agent যুগে Website Owner-দের কী করা উচিত?
Internet-এ Website তৈরি করা হচ্ছে মানুষের জন্য—কিন্তু সেই Website কে বেশি visit করছে?
মানুষ, নাকি Bot?
2026 সালে এই প্রশ্নটি আর শুধু theoretical নয়।
Cloudflare-এর 2026 Annual Founders’ Letter অনুযায়ী তাদের network data-তে May 2026-এ automated traffic human traffic-কে ছাড়িয়ে গেছে।
Cloudflare আগে ধারণা করেছিল এই crossover 2027 সালের দ্বিতীয়ার্ধে হতে পারে। কিন্তু AI Agent ও AI Crawler-এর দ্রুত growth-এর কারণে ঘটনাটি আরও আগে ঘটেছে।
তবে এখানে একটি গুরুত্বপূর্ণ বিষয় পরিষ্কার রাখা দরকার:
Cloudflare বলেনি যে AI Agent Traffic একাই সব Human Traffic-এর চেয়ে বেশি।
বরং তাদের observation হলো:
সব ধরনের Automated Traffic মিলিয়ে Human Traffic-কে ছাড়িয়েছে, এবং AI Agent ও AI Crawler এই বৃদ্ধির গুরুত্বপূর্ণ driver।
Website Owner-এর জন্য এর অর্থ কী?
আগে Website Traffic বলতে আমরা ভাবতাম:
Visitor → Page View → Lead → Sale
এখন সেই flow-এর পাশাপাশি তৈরি হচ্ছে:
AI Bot → Crawl → Content Read → AI Answer → হয়তো Human Referral, হয়তো কিছুই না
ফলে Website Bandwidth, CPU, Server Resource, SEO এবং Online Business-এর Economics—সবকিছুর হিসাব বদলাতে শুরু করেছে।
Automated Traffic কী?
Automated Traffic হলো এমন Web Request যা মানুষ Browser দিয়ে manually করছে না।
Software, Script, Bot, Crawler বা Agent Website access করছে।
এর মধ্যে থাকতে পারে:
- Search Engine Crawler
- AI Training Crawler
- AI Search Bot
- AI Assistant
- Browser Automation Agent
- Monitoring Bot
- Security Scanner
- Scraper
- Spam Bot
- Malicious Bot
তাই:
Bot = খারাপ
এই ধারণাটি সঠিক নয়।
Googlebot-ও Bot।
কিন্তু Googlebot আপনার Website index করে Search Result-এ দেখাতে সাহায্য করতে পারে।
অন্যদিকে একটি malicious scraper আপনার Content copy করে Resource consume করতে পারে কিন্তু Business Value নাও দিতে পারে।
AI যুগে Bot Traffic এত দ্রুত বাড়ছে কেন?
আগে automated crawler-এর বড় একটি অংশ ছিল Search Engine-এর জন্য।
Search Engine সাধারণত Website Crawl করত যাতে পরে Search Result-এ Page দেখাতে পারে।
কিন্তু এখন নতুন AI ecosystem-এর জন্য Website বিভিন্ন purpose-এ crawl হতে পারে।
যেমন:
- AI Model Training
- AI Search
- Retrieval
- Real-time User Question
- Agent Task
- Data Aggregation
একটি AI Agent একটি single user-এর প্রশ্নের উত্তর দিতে গিয়ে একসঙ্গে অনেক Website access করতে পারে।
একজন মানুষ বনাম একজন AI Agent
ধরুন একজন মানুষ জানতে চায়:
“ঢাকায় ভালো ৫টি Restaurant কোনগুলো?”
মানুষ হয়তো:
- Google Search করবে
- 5–10টি Result দেখবে
- 3টি Website খুলবে
- শেষে একটি Restaurant choose করবে
কিন্তু AI Agent কী করতে পারে?
একই প্রশ্নে Agent:
- শত শত Result evaluate করতে পারে
- অনেক Restaurant Menu দেখতে পারে
- Review compare করতে পারে
- Location check করতে পারে
- Price compare করতে পারে
শেষে User-কে 3টি Recommendation দিতে পারে।
Cloudflare একটি illustrative example দিয়েছে যেখানে AI Agent একটি Restaurant recommend করার আগে প্রায় 1,000 Menu check করতে পারে।
শেষ পর্যন্ত একজন Restaurant Customer পেল।
কিন্তু অন্য শত শত Website Agent-এর Request Serve করল—Human Customer পেল না।
এখানেই Website Owner-এর নতুন Problem
আগের Search Engine Model ছিল অনেকটা:
Crawler আপনার Content নেয় → Search Engine আপনাকে Visitor পাঠায়।
AI যুগে সবসময় এই balance থাকে না।
এখন হতে পারে:
Crawler 1,000 Page পড়ে → AI Answer বানায় → User আপনার Website-এ না-ও আসে।
এখানেই শুরু হচ্ছে Crawl-to-Referral Problem।
Crawl-to-Referral Ratio কী?
এটি সহজভাবে বোঝায়:
একটি Platform আপনার Website কতবার Crawl করছে এবং তার তুলনায় কত Human Visitor আপনার Website-এ পাঠাচ্ছে।
ধরুন:
1,000 Crawl → 1 Human Visit
তাহলে Ratio প্রায়:
1000:1
অর্থাৎ আপনি 1,000 Request-এর Server Cost দিচ্ছেন, কিন্তু পাচ্ছেন মাত্র একজন Visitor।
Cloudflare-এর historical data বিভিন্ন AI Platform-এর ক্ষেত্রে Search Engine-এর তুলনায় অনেক বেশি Crawl-to-Referral Ratio দেখিয়েছে।
তাই Content Publisher ও Website Owner-দের কাছে প্রশ্নটি গুরুত্বপূর্ণ হয়ে উঠেছে:
“Crawler আমার Content ব্যবহার করছে—কিন্তু এর বিনিময়ে আমি কী পাচ্ছি?”
2026-এ AI Training Crawling কতটা বড়?
Cloudflare-এর June 2026 analysis অনুযায়ী crawler request-এর উল্লেখযোগ্য অংশ AI Training-related।
তাদের data-তে AI Training purpose crawler request প্রায় 52% পর্যন্ত পৌঁছেছিল, যেখানে আগের বছরের তুলনায় share অনেক কম ছিল।
একই সঙ্গে Mixed-use Crawler—যেগুলো Search + Agent + Training-এর মতো একাধিক purpose serve করে—তাদের share-ও বড় হয়েছে।
এতে Bot Management আরও complex হয়ে যায়।
কারণ একই Crawler আপনার জন্য useful-ও হতে পারে, আবার আপনার Content Training-এর জন্য ব্যবহারও করতে পারে।
Search Bot, AI Agent ও Training Bot—Difference কী?
সব Bot একইভাবে treat করলে ভুল হতে পারে।
Search Bot
Search Engine Index তৈরি করার জন্য Content Crawl করে।
Goal:
আপনার Page Search Result-এ discoverable করা।
এটি সাধারণত Website Owner-এর জন্য valuable।
AI Training Bot
Website Content সংগ্রহ করে AI Model train বা fine-tune করতে ব্যবহার করতে পারে।
এখানে immediate referral পাওয়ার guarantee নেই।
Content Publisher-এর সবচেয়ে বড় concern এখানেই।
AI Agent
Real-time-এ একজন User-এর হয়ে কোনো Task করতে পারে।
যেমন:
“আমার জন্য best Hosting Plan খুঁজে দাও।”
Agent Website visit করতে পারে, Pricing compare করতে পারে, Feature analyze করতে পারে এবং User-কে Recommendation দিতে পারে।
এখানে Agent Traffic potentially Customer Acquisition Channel-ও হতে পারে।
তাহলে সব AI Bot Block করা উচিত?
না।
এটাই সবচেয়ে গুরুত্বপূর্ণ decision।
Blindly সব Bot block করলে future discovery opportunity হারাতে পারেন।
বিশেষ করে Search Crawlers block করলে:
- Search Indexing
- Organic Visibility
- Search Referral
ক্ষতিগ্রস্ত হতে পারে।
আর কিছু AI Search/Agent bot future customer আপনার Website-এ আনতে পারে।
তাই better strategy:
Identify → Classify → Measure → তারপর Allow/Block Decide করুন।
Cloudflare কেন Search, Agent ও Training আলাদা করেছে?
AI Traffic-এর behaviour আলাদা হওয়ায় Cloudflare Bot Traffic-কে broadly তিনভাবে control করার option দিয়েছে:
Search
Agent
Training
এর ফলে Website Owner চাইলে:
Search Allow করতে পারে,
Training Block করতে পারে,
Agent-এর জন্য আলাদা decision নিতে পারে।
এটি previous “সব AI Bot block করুন” approach-এর তুলনায় বেশি granular।
Search Bot Block করলে SEO ক্ষতি হতে পারে?
হ্যাঁ।
যে Crawler Search Indexing-এর জন্য প্রয়োজন, সেটি block করলে Search Engine আপনার Content:
- Discover করতে না পারে
- Recrawl করতে না পারে
- Update detect করতে না পারে
ফলে SEO negatively affected হতে পারে।
তাই শুধু “AI” label দেখে Bot block করবেন না।
Crawler-এর purpose বুঝুন।
robots.txt কি AI Bot Block করতে পারে?
robots.txt মূলত Website Owner-এর preference communicate করে।
আপনি বলতে পারেন:
এই Bot এই Section Crawl করবে না।
কিন্তু robots.txt একটি request বা directive।
Technical Firewall নয়।
Crawler যদি robots.txt respect না করে, তাহলে File নিজে Request Block করতে পারবে না।
robots.txt এবং WAF-এর Difference
সহজভাবে:
robots.txt = “Please crawl করবেন না।”
WAF/AI Crawl Control = “Request technically block করা।”
অর্থাৎ robots.txt preference signal।
WAF enforcement layer।
দুটো একসঙ্গে ব্যবহার করা যেতে পারে।
AI Bot কি robots.txt Ignore করতে পারে?
হ্যাঁ।
সব Crawler voluntarily robots.txt respect করে—এমন guarantee নেই।
এই কারণেই Website Owner-এর জন্য শুধু robots.txt নয়, Server/WAF-level controlও গুরুত্বপূর্ণ হতে পারে।
Bot Traffic Website Bandwidth কীভাবে খায়?
প্রতিটি Crawler Request-এর response দিতে Server Data Send করে।
যদি Bot:
- HTML
- Image
- CSS
- JSON
- API Data
download করে, Bandwidth use হয়।
একটি Request ছোট মনে হলেও লক্ষ লক্ষ Request হলে Usage বড় হতে পারে।
ছোট Website-এ Bot Traffic বেশি Problem কেন?
Large Website-এর Server Resource অনেক বেশি হতে পারে।
কিন্তু Small Business Website যদি Low-resource Shared Hosting-এ থাকে, aggressive crawling noticeable impact তৈরি করতে পারে।
যেমন:
- CPU Usage বাড়ে
- PHP Request বাড়ে
- Bandwidth বাড়ে
- Database Query বাড়ে
- Entry Process বাড়ে
ফলে Real Visitor-এর Website Slow হতে পারে।
AI Bot কি 508 Resource Limit Error তৈরি করতে পারে?
Indirectly পারে।
যদি অনেক Bot একই সময়ে Dynamic Page Request করে এবং Hosting Account-এর:
- Entry Process
- CPU
- RAM
pressure বাড়ায়, তাহলে Resource Limit hit হতে পারে।
CloudLinux Environment-এ Entry Process Limit reach করলে 508 Resource Limit Is Reached-এর মতো error দেখা যেতে পারে।
তবে 508 দেখলেই AI Bot responsible—এমন ধরে নেওয়া যাবে না।
Resource Usage এবং Logs check করতে হবে।
Bot Traffic এবং CPU Usage-এর Relation
Static Cached Page Serve করা আর Dynamic WooCommerce Page generate করা এক জিনিস নয়।
Bot যদি repeatedly:
- Search Page
- Filter Page
- Dynamic Product Page
- API Endpoint
hit করে, Server বেশি CPU/Database Resource ব্যবহার করতে পারে।
WordPress Website Bot-এর জন্য বেশি Resource ব্যবহার করতে পারে কেন?
WordPress dynamic application।
Uncached Request-এর ক্ষেত্রে প্রয়োজন হতে পারে:
Web Server → PHP → WordPress Core → Plugin → Database → HTML
Bot যদি প্রতি Second-এ অনেক uncached URL request করে, resource usage বাড়তে পারে।
Cache কেন গুরুত্বপূর্ণ?
Cache Dynamic Page-এর pre-generated version serve করতে পারে।
ফলে প্রতিটি Bot Request-এর জন্য পুরো PHP/Database process চালানোর দরকার কমে।
এই কারণে caching শুধু Human Visitor Speed-এর জন্য নয়।
Bot-heavy Internet-এর জন্যও useful।
CDN ব্যবহার করলে কী Benefit?
CDN cached static content Origin Server-এর পরিবর্তে Edge থেকে Serve করতে পারে।
ফলে:
- Origin Bandwidth কমে
- Server Load কমে
- Static Asset দ্রুত serve হয়
High Bot Traffic Website-এর জন্য এটি useful layer।
সব AI Crawler কি বারবার একই Page Fetch করে?
Cloudflare-এর 2026 data অনুযায়ী good bot-রা যে content fetch করে তার অর্ধেকেরও বেশি previous crawl-এর পর পরিবর্তন হয়নি।
অর্থাৎ Server বারবার unchanged content serve করছে।
এটি efficiency problem।
Web ecosystem future-এ crawler-কে শুধু changed content fetch করানোর দিকে যেতে পারে।
AI Agent কি Future Customer আনতে পারে?
হ্যাঁ—এটাই Bot Traffic-এর positive side।
ধরুন একজন User AI Assistant-কে বলল:
“বাংলাদেশে ভালো Premium Hosting Provider suggest করো।”
Agent বিভিন্ন Hosting Website analyze করতে পারে।
যদি আপনার Website clearly communicate করে:
- Service
- Price
- Feature
- Support
- Location
- Policies
- Business Information
তাহলে Agent আপনার Business understand করার সুযোগ পাবে।
Future SEO কি AI Agent-এর জন্যও করতে হবে?
Search পুরো শেষ হয়ে যাবে—এমন নয়।
বরং Website Discovery Channel বাড়ছে।
আগে:
Google SEO
এখন gradually:
Search SEO + AI Search + Agent Discovery
Website এমন হওয়া দরকার যাতে:
Human বুঝতে পারে + Search Engine বুঝতে পারে + AI Agent বুঝতে পারে।
AEO কী?
AEO সাধারণত:
Answer Engine Optimization
বোঝাতে ব্যবহার করা হয়।
অর্থাৎ Content এমনভাবে তৈরি করা যাতে AI/Search Answer Engine আপনার Content থেকে clear answer understand করতে পারে।
তবে AEO কোনো magic SEO replacement নয়।
Strong Website Foundation এখনও দরকার।
AI Agent-friendly Website কেমন?
Agent-friendly Website মানে Robot-এর জন্য আলাদা Website নয়।
বরং Website information clear এবং structured থাকবে।
যেমন:
- পরিষ্কার Service Name
- Accurate Price
- Feature Table
- FAQ
- Contact Information
- Policy
- Structured Data
- Fast Page
- Stable URL
এগুলো Human-এর জন্যও ভালো।
Hosting Website-এর Example
ধরুন Website-এ লেখা:
Premium Hosting
কিন্তু:
- RAM নেই
- CPU নেই
- Backup তথ্য নেই
- Support details নেই
- Price unclear
AI Agent-এর জন্য compare করা কঠিন।
এর বিপরীতে structuredভাবে যদি থাকে:
- Storage
- CPU
- RAM
- Backup
- Support
- Server Location
- Price
তাহলে Agent Information parse করা সহজ হতে পারে।
E-commerce Website-এর জন্য AI Agent Opportunity
Future Shopping Agent বলতে পারে:
“৳3,000-এর মধ্যে Black Running Shoe খুঁজে দাও।”
Agent অনেক Store crawl করতে পারে।
আপনার Product Page-এ যদি থাকে:
- Product Name
- Price
- Stock
- Size
- Color
- Product Image
- Delivery Information
তাহলে Machine-এর জন্য Product compare করা সহজ।
E-commerce Owner এখন কী করবে?
Product Information clean রাখুন।
Especially:
Price
Availability
Product Title
Description
Structured Data
Return Policy
Delivery Information
যত clear হবে, Human এবং Machine—দুই ধরনের visitor-এর জন্য ভালো।
Blog Website-এর জন্য কী পরিবর্তন আসছে?
আগে Blogger-এর Goal:
Google Rank → User Click → Article Read
এখন User AI-কে question করতে পারে।
AI আপনার Article পড়ে answer দিতে পারে।
User Article-এ না-ও আসতে পারে।
Publisher-এর challenge:
Content Visibility এবং Direct Traffic-এর মধ্যে নতুন balance।
Content Publisher কেন Concerned?
Publisher-এর Business Model হতে পারে:
- Ads
- Affiliate
- Subscription
- Product
- Lead
Revenue পেতে Human Visitor প্রয়োজন।
Crawler যদি Content consume করে কিন্তু Human Visit না পাঠায়, Publisher Server Cost বহন করছে—Revenue পাচ্ছে না।
AI Crawler Block করলে কি Content Protect হবে?
Crawling reduce করা যায়।
কিন্তু public Web Content পুরোপুরি copy-proof করা practically কঠিন।
Goal সাধারণত:
- Unwanted automated access কমানো
- Resource protect করা
- Preference communicate করা
Cloudflare AI Crawl Control কী?
Cloudflare AI Crawl Control Website Owner-কে AI crawler activity monitor এবং control করার tools দেয়।
আপনি দেখতে পারেন:
- কোন Crawler আসছে
- Operator কে
- কত Request করছে
- Category কী
- robots.txt violation আছে কি না
তারপর Crawler অনুযায়ী action নেওয়া যায়।
Free Plan-এ কি AI Crawl Control আছে?
Cloudflare-এর AI Crawl Control সব plan-এ available।
তবে detection capability plan অনুযায়ী more advanced হতে পারে।
Free Plan well-known self-identifying crawler user agent-এর ওপর বেশি depend করতে পারে।
AI Crawl Control-এ কী করবেন?
Cloudflare ব্যবহার করলে প্রথমে Dashboard খুলুন।
তারপর AI Crawl Control-এ গিয়ে দেখুন:
কোন Bot আপনার Website Crawl করছে।
প্রথম দিনই সব block করবেন না।
আগে data collect করুন।
কোন Data দেখবেন?
বিশেষভাবে:
- Total Requests
- Crawler Name
- Operator
- Category
- Trend
- Robots.txt Violation
- Most Crawled Page
দেখুন।
Crawl Spike কী?
ধরুন আপনার Website normally 10,000 Bot Request/day পায়।
হঠাৎ:
300,000 Request/day
হয়ে গেল।
এটি Crawl Spike।
এর ফলে:
- Bandwidth
- Server Load
- Origin Requests
বাড়তে পারে।
AI Bot আর Malicious Bot একই?
না।
AI Crawler legitimate bot হতে পারে।
Malicious Bot-এর উদ্দেশ্য হতে পারে:
- Credential Attack
- Spam
- Scraping
- Inventory Hoarding
- Vulnerability Scan
এই traffic Bot Management/WAF-এর মাধ্যমে আলাদাভাবে handle করা দরকার।
Good Bot কী?
Good Bot সাধারণত legitimate useful purpose serve করে।
যেমন:
- Search Engine
- Uptime Monitor
- Verified Service
- User-requested Agent
কিন্তু “Good Bot” হলেও resource consume করবে।
তাই Good মানে Zero Cost নয়।
সব Search Engine Bot Allow করবেন?
সাধারণত major legitimate search crawler allow করা SEO-এর জন্য useful।
তবে fake crawler legitimate User-Agent ব্যবহার করতে পারে।
Advanced detection IP Verification বা Bot Management-এর মাধ্যমে useful হতে পারে।
AI Training Block করলে Google SEO নষ্ট হবে?
এখানে careful হতে হবে।
কিছু crawler multiple purpose serve করতে পারে।
Search এবং Training একই crawler identity ব্যবহার করলে Training block করার policy Search crawling-এও impact তৈরি করতে পারে।
তাই configuration apply করার আগে crawler behavior এবং provider documentation বুঝে নিন।
Cloudflare নতুন Domain-এ কী Default করছে?
September 2026 থেকে Cloudflare নতুন onboarding domain-এর কিছু page-এর জন্য Agent ও Training traffic-এর বিরুদ্ধে stricter default দিয়েছে, বিশেষ করে ad-supported pages-এর context-এ।
Search traffic allow রাখাকে তারা discovery-এর জন্য useful হিসেবে consider করছে।
তবে Website Owner নিজের preference অনুযায়ী change করতে পারে।
Website-এ Ads থাকলে AI Bot কেন Problem?
Ad-supported Website Human Page View থেকে আয় করে।
AI Agent Content পড়ল কিন্তু Human Page Load হলো না।
তাহলে:
- Ad impression হলো না
- Publisher Revenue পেল না
- Server Resource use হলো
Publisher economics-এর সমস্যা এখানেই।
AI Agent Traffic কি Conversion আনতে পারে?
পারে।
কিন্তু track করা কঠিন হতে পারে।
Agent:
- আপনার Website পড়ে
- User-কে information দেয়
- User পরে Brand Name Search করে
- Website-এ আসে
এই conversion traditional referral analytics-এ directly AI source হিসেবে দেখা নাও যেতে পারে।
তাহলে AI Traffic-এর ROI Measure করবেন কীভাবে?
শুধু Referral নয়।
Observe করুন:
- Brand Search Growth
- Direct Traffic
- AI Referral
- Conversion
- Bot Crawl Volume
- Server Cost
একটি wider picture দরকার।
Server Cost-এর হিসাব করুন
ধরুন:
Human Traffic একই আছে।
কিন্তু Bot Request 3x হয়ে গেছে।
তাহলে Hosting Resource বাড়তে পারে—Business Revenue একই থাকতে পারে।
এই situation detect না করলে Website Owner ভাবতে পারে:
“Traffic তো বাড়েনি, Hosting কেন Slow?”
আসলে Backend Request বাড়ছে।
Analytics-এ Bot Traffic সবসময় দেখা যায়?
না।
Traditional JavaScript Analytics সব Bot capture করে না।
কারণ crawler JavaScript execute নাও করতে পারে।
তাই Analytics-এ 10,000 Visitor দেখালেও Server Log-এ অনেক বেশি HTTP Request থাকতে পারে।
Bot Traffic দেখার ভালো জায়গা কোথায়?
Useful source:
- Cloudflare Analytics
- Bot Analytics
- AI Crawl Control
- Web Server Access Logs
- Hosting Resource Usage
শুধু Google Analytics দেখে Bot Load বুঝবেন না।
Hosting Provider-এর Role কী?
Hosting Provider Server Level-এ দেখতে পারে:
- Request Rate
- IP Activity
- CPU
- RAM
- Bandwidth
- Web Server Log
- Abuse Pattern
Shared Hosting User সব information access নাও পেতে পারে।
WordPress Owner-এর Practical Checklist
| Area | কী করবেন |
|---|---|
| Cache | Proper Page Cache |
| CDN | Static Content Edge-এ Serve |
| Bot Traffic | Monitor |
| Search Bots | Blindly Block নয় |
| AI Training | Business Preference অনুযায়ী |
| WAF | Malicious Traffic Control |
| Images | Optimize |
| Database | Optimize |
| Plugin | Heavy Plugin Review |
| Hosting | Resource Usage Monitor |
WooCommerce Website-এর Extra Risk
WooCommerce-এর অনেক Page dynamic।
যেমন:
- Cart
- Checkout
- Search
- Filter
- My Account
Bot যদি এমন page repeatedly access করে, caching benefit কম হতে পারে।
ফলে Resource Pressure বেশি হতে পারে।
WooCommerce Owner কী করবেন?
Bot যেন unnecessary:
- Cart URL
- Internal Search
- Infinite Filter
- Parameter URL
crawl না করে সেটি review করুন।
কারণ হাজার হাজার URL combination crawler trap তৈরি করতে পারে।
Crawl Trap কী?
Crawl Trap হলো এমন URL structure যেখানে Bot virtually endless Page generate করতে পারে।
যেমন:
Filter combination:
Color + Size + Brand + Sort + Price
প্রতিটি combination নতুন URL।
Bot সব crawl করার চেষ্টা করলে Server Load অনেক বেড়ে যেতে পারে।
WordPress Search Page Bot-এর জন্য Expensive হতে পারে কেন?
Search Request Database Query চালাতে পারে।
Bot যদি thousands of different search query generate করে, CPU/Database load বাড়তে পারে।
WAF/Rate Limiting useful হতে পারে।
Rate Limiting কী?
Rate Limiting নির্ধারণ করে একটি Client/IP নির্দিষ্ট সময়ে কত Request করতে পারবে।
Aggressive automation control করতে useful।
তবে legitimate Search Bot accidentally block না হয় সেদিকে খেয়াল রাখতে হবে।
AI Agent-এর জন্য আলাদা Content বানাতে হবে?
এই মুহূর্তে আলাদা duplicate Website দরকার নেই।
বরং existing Website improve করুন।
Focus:
- Clear Content
- Fast Load
- Structured Data
- Accurate Information
- Logical Navigation
FAQ কি AI Discovery-তে useful?
FAQ clear question-answer structure তৈরি করে।
Human User ও Machine দুজনের জন্য useful হতে পারে।
তবে শুধু AI-এর জন্য শত শত low-quality FAQ তৈরি করবেন না।
Quality important।
Structured Data কেন গুরুত্বপূর্ণ?
Structured Data Search Engine/Systems-কে Page-এর meaning বোঝাতে সাহায্য করে।
Business অনুযায়ী:
- Product
- Organization
- Article
- Breadcrumb
- Local Business
useful হতে পারে।
AI যুগে SEO কি মারা যাবে?
না।
SEO evolve করবে।
Search Engine এখনও Web Discovery-এর বড় channel।
বরং future strategy হবে:
Search Visibility + AI Visibility + Brand Authority
Zero-click Search আরও বাড়তে পারে?
AI Answer User-কে Website Visit না করেই তথ্য দিতে পারে।
ফলে informational query-এর direct click কিছু ক্ষেত্রে কমতে পারে।
তাই Business Website-এর Content শুধু generic answer-এর মধ্যে সীমাবদ্ধ না রেখে unique value দিতে হবে।
কী ধরনের Content AI সহজে replace করতে পারবে?
Generic information:
“Domain কী?”
AI সহজেই summarize করতে পারে।
কিন্তু:
- Original Research
- Real Price
- Live Product
- Local Service
- Tool
- Calculator
- Customer Support
- Unique Data
এর direct Website value বেশি।
Blog Strategy কীভাবে বদলাবেন?
শুধু basic definition article নয়।
Add করুন:
- Original Experience
- Data
- Screenshot
- Comparison
- Case Study
- Checklist
- Unique Local Context
এতে Content-এর value বাড়ে।
Bangladesh Business-এর জন্য Opportunity কোথায়?
Local information AI-এর জন্য valuable।
যেমন:
- Bangladesh Pricing
- Local Payment
- BDT Cost
- Local Hosting
- BDIX
- Local Delivery
- Bangladesh Business Rules
এই information accurate ও structured হলে AI Search/Agent-এর জন্য useful source হওয়ার chance বাড়ে।
RoyelHost-এর মতো Hosting Business-এর জন্য কী Opportunity?
Hosting Website-এ পরিষ্কারভাবে থাকা উচিত:
- Hosting Type
- Server Location
- CPU
- RAM
- Storage
- Backup
- Uptime
- Support
- Price
- Upgrade Path
তাহলে Human Customer ও AI Agent—দুজনই service সহজে compare করতে পারবে।
Premium Hosting কখন দরকার হতে পারে?
Bot Traffic-এর কারণে temporary resource spike হলেও সঙ্গে সঙ্গে upgrade দরকার নেই।
আগে optimize করুন।
কিন্তু যদি:
- Real User বাড়ছে
- Bot + Human Load regularly high
- WooCommerce grow করছে
- CPU/EP regularly limit hit করছে
তাহলে higher-resource Premium Hosting useful হতে পারে।
কখন VPS-এ যাবেন?
VPS evaluate করুন যখন:
- Dedicated Resource দরকার
- Root Access দরকার
- Custom WAF/Server Config দরকার
- High Request Volume
- Heavy WooCommerce
- Large Application
Shared Hosting limitation regularly bottleneck হলে VPS logical next step।
VPS নিলেই Bot Problem Solve?
না।
Resource বাড়বে।
কিন্তু unlimited নয়।
Aggressive Bot 8GB RAM VPS-ও waste করতে পারে।
Server Management + Cache + WAF + Rate Limit still দরকার।
Dedicated Server কখন দরকার?
Large-scale:
- E-commerce
- SaaS
- Hosting Platform
- High Traffic Portal
এর জন্য Dedicated Server relevant হতে পারে।
তবে শুধু Bot Traffic দেখে Dedicated Server নেওয়া উচিত নয়।
Website Owner-এর জন্য 10-Step Action Plan
Step 1 — Bot Traffic Measure করুন
Guess করবেন না।
Cloudflare/Logs দেখুন।
Step 2 — Bot Classification দেখুন
Search, Agent, Training আলাদা করুন।
Step 3 — Search Engine Bot Protect করুন
SEO impact বোঝা ছাড়া block করবেন না।
Step 4 — Training Policy Decide করুন
আপনি Content Training-এর জন্য allow করবেন কি না ঠিক করুন।
Step 5 — Agent Traffic Evaluate করুন
Future Customer Acquisition Value থাকতে পারে।
Step 6 — robots.txt Review করুন
আপনার preference clear রাখুন।
Step 7 — Enforcement দরকার হলে WAF ব্যবহার করুন
robots.txt alone technical block নয়।
Step 8 — Cache + CDN Optimize করুন
Bot Request-এর Origin Cost কমান।
Step 9 — Resource Usage Monitor করুন
CPU/RAM/EP/Bandwidth দেখুন।
Step 10 — Business Result Compare করুন
Bot Load-এর বিনিময়ে Referral/Lead/Revenue পাচ্ছেন কি না দেখুন।
সব Bot Block করা কেন সবচেয়ে বড় Mistake হতে পারে?
কারণ Internet Discovery-এর বড় অংশ automated crawler-এর ওপর নির্ভর করে।
সব Bot block করলে Search Engine-ও ক্ষতিগ্রস্ত হতে পারে।
Future AI Agent-driven Customer Discovery-ও হারাতে পারেন।
Better Approach:
Useful Bot Allow করুন, Harmful Bot Control করুন।
আবার সব Bot Allow করাও কি ভালো?
না।
Unlimited Crawl দিলে:
- Server Cost বাড়তে পারে
- Content Scraping হতে পারে
- Training Crawling হতে পারে
- Malicious Bot ঢুকতে পারে
তাই balance দরকার।
AI Training Allow করব নাকি Block?
একটি universal answer নেই।
যদি আপনার Goal:
Maximum AI exposure
তাহলে Allow consider করতে পারেন।
যদি Content:
- Premium
- Copyright-sensitive
- Ad-supported
- High Infrastructure Cost
হয়, Training Crawling restrict করা Business Decision হতে পারে।
AI Agent Allow করব?
Agent future buyer/user-এর behalf-এ কাজ করতে পারে।
তাই Commercial Website-এর জন্য Agent traffic potentially valuable।
কিন্তু Request Volume monitor করুন।
News/Blog Publisher কী করবে?
Publisher-এর priority হতে পারে:
Search Referral protect + Training Crawl control + Server Cost limit।
তাই category-based policy useful।
E-commerce Website কী করবে?
E-commerce-এর Goal:
Product discoverability
তাই Search/Shopping/Agent discovery valuable হতে পারে।
Training crawler-এর value আলাদা।
Company Website কী করবে?
Business Website সাধারণত discoverable থাকতে চায়।
তাই Search ও legitimate Agent-এর জন্য accessible থাকা future lead generation-এর অংশ হতে পারে।
AI Bot Traffic-এর ভবিষ্যৎ কী?
Cloudflare-এর assessment অনুযায়ী automated traffic দ্রুত বাড়ছে।
তারা এমনকি trend continue করলে কয়েক বছরের মধ্যে automated traffic human traffic-এর তুলনায় বহু গুণ বড় হতে পারে বলে projection দিয়েছে।
এটি prediction—guarantee নয়।
কিন্তু direction clear:
Internet শুধু Human Browser-এর জন্য নয়।
Machine Client-এর share বাড়ছে।
Website Architecture কি বদলাতে হবে?
Long term-এ Websiteকে support করতে হবে:
Human Traffic + Search Crawler + AI Agent
তাই scalable architecture গুরুত্বপূর্ণ।
- Cache
- CDN
- API Efficiency
- Clean HTML
- Structured Data
- Server Capacity
সব আরও important হবে।
AI Agent কি Website-এর Button Click করবে?
Already কিছু Browser-use Agent Website navigate, click এবং form interaction করতে পারে।
Future-এ আরও বেশি automated action হতে পারে।
তাই:
- Accessible Form
- Clear Button
- Stable Navigation
Human UX-এর পাশাপাশি agent usability-তেও value দিতে পারে।
Bot Traffic কি Security Risk?
কিছু Bot legitimate।
কিছু Bot malicious।
High automation era-তে:
- Credential Stuffing
- Scraping
- Spam
- Vulnerability Scanning
আরও automate হতে পারে।
তাই WAF/Bot Protection আরও গুরুত্বপূর্ণ হবে।
AI Bot Blocker আর Security WAF কি একই?
না।
AI Crawl Control:
Content access preference manage করতে পারে।
WAF:
Malicious Web Attack filter করে।
দুটোর purpose আলাদা।
Analytics Strategy বদলাতে হবে?
হ্যাঁ।
Website Owner শুধু:
Sessions / Users
দেখলে full picture miss করতে পারে।
Monitor করুন:
Human Traffic + Bot Request + Server Cost + Referral + Conversion
Hosting Provider-এর জন্য Future Challenge
Hosting Industry-কে handle করতে হবে:
Human Traffic বাড়েনি, কিন্তু HTTP Request কয়েকগুণ বেড়েছে।
Plan Resource Design, abuse control এবং caching strategy-তে Bot Traffic increasingly important হবে।
Website Owner-এর সবচেয়ে গুরুত্বপূর্ণ প্রশ্ন
আজ থেকে শুধু জিজ্ঞেস করবেন না:
“আমার Website-এ কত Visitor?”
আরও জিজ্ঞেস করুন:
“আমার Server কে ব্যবহার করছে?”
Human?
Google?
AI Agent?
AI Training Bot?
Malicious Scraper?
এই distinction future Website Management-এর গুরুত্বপূর্ণ অংশ।
Final Checklist
| Question | Check |
|---|---|
| Automated Traffic কত? | Cloudflare/Logs |
| কোন Bot আসছে? | Bot Analytics |
| Search Bot? | Allow carefully |
| AI Training? | Business policy |
| AI Agent? | Value evaluate |
| robots.txt আছে? | Review |
| Bot Rules আছে? | Configure |
| Cache আছে? | Enable |
| CDN আছে? | Optimize |
| Server Limit hit করছে? | Monitor |
| Referral পাচ্ছেন? | Measure |
| Conversion হচ্ছে? | Track |
তাহলে মানুষের চেয়ে Bot Traffic বেশি হওয়া কি ভয় পাওয়ার বিষয়?
শুধু ভয় পাওয়ার বিষয় নয়।
এটি Internet-এর structure বদলানোর signal।
Cloudflare-এর data অনুযায়ী May 2026-এ automated traffic human traffic-কে ছাড়িয়েছে।
AI Agents এবং AI Crawlers এই পরিবর্তন accelerate করছে।
Website Owner-এর সামনে এখন দুটি challenge:
Resource protect করা
এবং
Future AI-driven discovery miss না করা।
যে Website Owner সব Bot blindly block করবে, সে future opportunity হারাতে পারে।
আবার যে সব automated request unrestricted allow করবে, সে unnecessary Server Cost বহন করতে পারে।
Best Strategy:
Measure → Understand → Classify → Control
Final Conclusion
Internet ধীরে ধীরে:
Human Web → Human + Agent Web
এ রূপান্তরিত হচ্ছে।
আগে Website Owner-এর সবচেয়ে বড় প্রশ্ন ছিল:
Google-এ Rank করছি কি?
ভবিষ্যতে প্রশ্ন হতে পারে:
AI Agent আমার Business বুঝতে পারছে কি?
AI Bot আমার Resource কতটা ব্যবহার করছে?
এই Crawling থেকে Customer পাচ্ছি কি?
Cloudflare-এর observation অনুযায়ী Automated Traffic already Human Traffic-এর threshold cross করেছে।
এর মানে Website Owner-দের এখন থেকেই Bot Traffic নিয়ে serious হওয়া উচিত।
কিন্তু solution:
সব Bot Block করা নয়।
Solution হলো:
Search Bot রাখুন যেখানে discovery দরকার → AI Agent-এর Business Value evaluate করুন → unwanted Training/Scraping control করুন → Cache/CDN ব্যবহার করুন → Server Resource Monitor করুন।
আর Website grow করতে থাকলে এমন Hosting Environment ব্যবহার করুন যেখানে CPU, RAM, Entry Process, Bandwidth ও scalability business-এর সঙ্গে grow করতে পারে।
Growing WordPress বা Business Website-এর জন্য RoyelHost Premium Hosting-এর মতো higher-resource Hosting evaluate করা যেতে পারে।
আর বেশি dedicated resource, control এবং custom configuration প্রয়োজন হলে VPS Hosting consider করা যায়।
AI Agent যুগে Website শুধু মানুষের জন্য একটি Page নয়।
এটি Human, Search Engine এবং Machine Agent—তিন পক্ষের জন্য একটি Digital Business Endpoint হয়ে উঠছে।
সাধারণ প্রশ্ন ও উত্তর
Cloudflare কি বলেছে Bot Traffic মানুষের চেয়ে বেশি?
Cloudflare-এর 2026 network observations অনুযায়ী May 2026-এ overall automated traffic human traffic-কে ছাড়িয়েছে।
AI Agent Traffic একাই কি Human Traffic-এর চেয়ে বেশি?
না। Claimটি overall automated traffic সম্পর্কে। AI Agent ও AI Crawler growth এই shift-এর গুরুত্বপূর্ণ driver।
সব Bot কি AI Bot?
না। Search Engine, Monitoring Bot, Security Botসহ অনেক automated traffic আছে।
AI Bot Website Slow করতে পারে?
High request volume হলে CPU, RAM, Bandwidth এবং concurrent request pressure বাড়াতে পারে।
AI Bot SEO-এর জন্য ভালো?
কিছু Search/AI Search crawler discovery ও referral আনতে পারে। সব Bot-এর behaviour এক নয়।
সব AI Bot Block করা উচিত?
না। Purpose বুঝে Search, Agent এবং Training traffic আলাদাভাবে manage করা ভালো।
robots.txt কি Bot Block করতে পারে?
robots.txt preference communicate করে। Technical enforcement নয়।
Bot technically block করতে কী লাগবে?
WAF, Bot Management বা AI Crawl Control-এর মতো enforcement layer ব্যবহার করা যায়।
AI Training Bot Block করলে SEO নষ্ট হবে?
Crawler অনুযায়ী impact আলাদা। কিছু multipurpose crawler Search ও Training দুটো কাজ করতে পারে, তাই configuration carefully করতে হবে।
Cloudflare AI Crawl Control কী?
AI crawler activity monitor এবং specific crawler allow/block করার জন্য Cloudflare-এর toolset।
Free Cloudflare User এটি ব্যবহার করতে পারে?
AI Crawl Control সব plan-এ available, তবে detection capability plan অনুযায়ী differ করতে পারে।
AI Bot কি 508 Error তৈরি করতে পারে?
Excessive dynamic requests Hosting Resource Limit-এর ওপর pressure তৈরি করতে পারে। তবে 508-এর root cause Resource Usage Data দেখে verify করা উচিত।
VPS নিলে Bot Traffic Problem শেষ হবে?
না। Resource বাড়বে, কিন্তু Bot Management এবং Optimization এখনও প্রয়োজন।
AI Agent কি Future Customer আনতে পারে?
হ্যাঁ। Agent Product/Service compare করে User-কে recommendation দিতে পারে।
No comments yet. Be the first to comment.